Domain rohrwelle.de kaufen?
Wir ziehen mit dem Projekt
rohrwelle.de um.
Sind Sie am Kauf der Domain
rohrwelle.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain rohrwelle.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **


Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
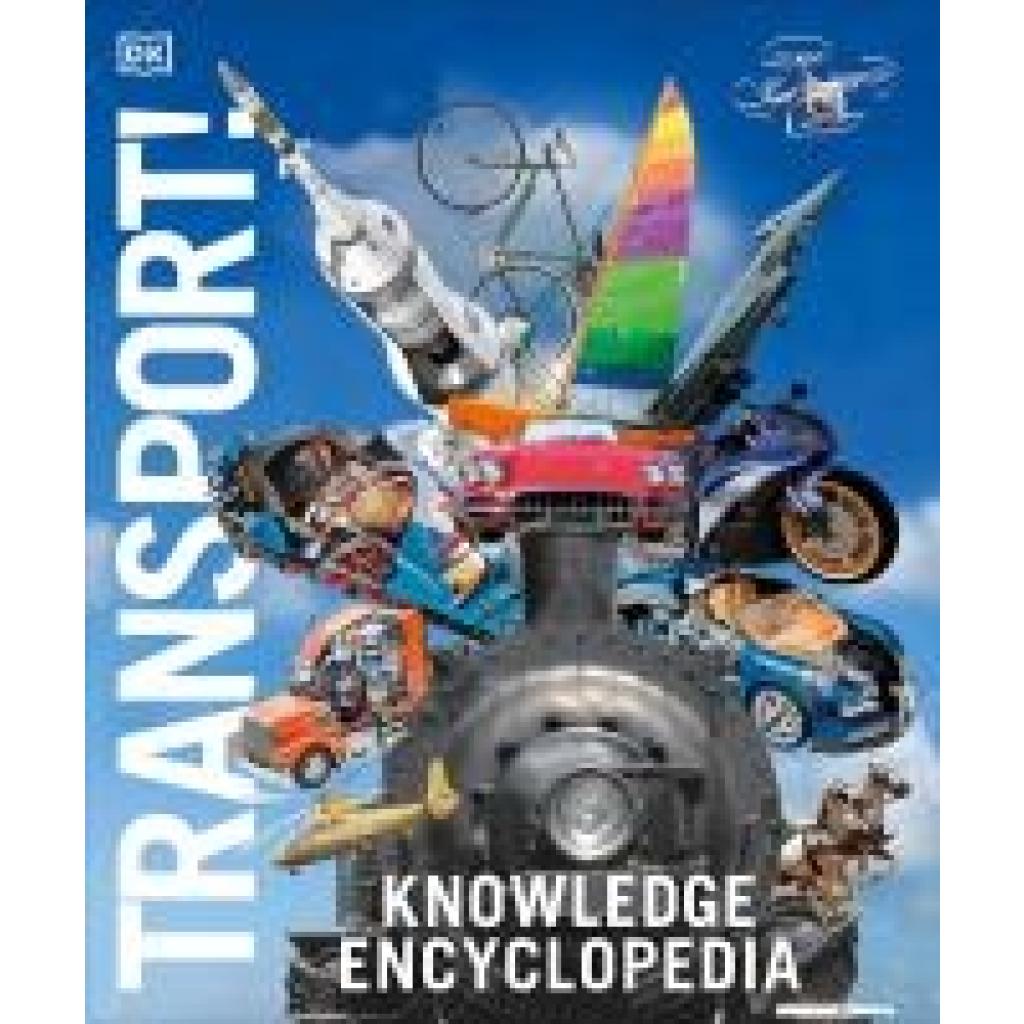
Knowledge Encyclopedia Transport!Knowledge Encyclopedia Transport! , DK's best-selling richly illustrated encyclopedia series explores the wonderful world of transport. Knowledge Encyclopedia: Transport! uses incredibly detailed 3D illustrations to show children aged 9+ everything they need to know about how vehicles work. Children will find themselves totally absorbed in complex subjects with the Knowledge Encyclopedia series, made clear through engaging explanations, intricate illustrations, vivid photographs, and striking 3D images. Meet hundreds of vehicles that float, fly, or speed across the land, including the record breakers - the fastest, largest, longest, and strangest modes of transportation ever to zoom, sail, or soar. This all-encompassing encyclopedia for kids offers: - A whole collection of facts, charts, timelines, and illustrations that cover a vast range of transportation. - Complex subjects that are explained using amazingly detailed CGIs that entice young readers to dive in and explore. - A visual approach using illustrations, photographs and extremely detailed 3D CGI images. Children can explore transportation as they've never seen it before, looking at groundbreaking topics like current and future craft that use green energy to transport people and goods around the world. Peer inside a car engine, feel the roar of a jet, watch a helicopter's rotor create lift, and explore below the decks of an ocean liner in this impressively detailed transport encyclopedia. More in the series Knowledge Encyclopedia Transport! is part of DK's visual and informative Knowledge Encyclopedia series. Complete the collection and dive into the deep with Knowledge Encyclopedia Ocean! , take a trip to the solar system with Knowledge Encyclopedia Space! and travel back to prehistoric times with Knowledge Encyclopedia Dinosaur ! , > , Erscheinungsjahr: 20240502, Produktform: Leinen, Seitenzahl/Blattzahl: 208, Themenüberschrift: JUVENILE NONFICTION / Transportation / Aviation, Keyword: transport book for kids; transport book for children; children's transport encyclopedia; kids transport encyclopedia; car book; train book; plane book; motorbike book; bus book; kids train book; car book for kids; boat book; children's encyclopedia; kids encyclopedia; kids book 9-12; childrens book 9-12; childrens book 10-11; kids book 10-11; childrens books age 9-11; kids books age 9 12; books for 9 year olds; books for 10 year olds; books for 11 year olds; books for 12 year olds, Fachschema: Englische Bücher / Kinderliteratur, Jugendliteratur / Sachbuch~Fahrzeug / Kindersachbuch, Jugendsachbuch~Flugzeug / Kindersachbuch, Jugendsachbuch~Schiff / Kindersachbuch, Jugendsachbuch, Fachkategorie: Kinder/Jugendliche: Nachschlagewerke: Enzyklopädien, allgemeine Nachschlagewerke, Interesse Alter: empfohlenes Alter: ab 9 Jahre, Altersempfehlung / Lesealter: 18, ab Alter: 9, bis Alter: 12, Imprint-Titels: DK Children, Warengruppe: HC/Kinderbücher/Sachbücher/Naturwissensch./Technik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 307, Breite: 261, Höhe: 22, Gewicht: 1352, Produktform: Gebunden, Genre: Importe,26,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Knowledge Encyclopedia Transport!Knowledge Encyclopedia Transport! , DK's best-selling richly illustrated encyclopedia series explores the wonderful world of transport. Knowledge Encyclopedia: Transport! uses incredibly detailed 3D illustrations to show children aged 9+ everything they need to know about how vehicles work. Children will find themselves totally absorbed in complex subjects with the Knowledge Encyclopedia series, made clear through engaging explanations, intricate illustrations, vivid photographs, and striking 3D images. Meet hundreds of vehicles that float, fly, or speed across the land, including the record breakers - the fastest, largest, longest, and strangest modes of transportation ever to zoom, sail, or soar. This all-encompassing encyclopedia for kids offers: - A whole collection of facts, charts, timelines, and illustrations that cover a vast range of transportation. - Complex subjects that are explained using amazingly detailed CGIs that entice young readers to dive in and explore. - A visual approach using illustrations, photographs and extremely detailed 3D CGI images. Children can explore transportation as they've never seen it before, looking at groundbreaking topics like current and future craft that use green energy to transport people and goods around the world. Peer inside a car engine, feel the roar of a jet, watch a helicopter's rotor create lift, and explore below the decks of an ocean liner in this impressively detailed transport encyclopedia. More in the series Knowledge Encyclopedia Transport! is part of DK's visual and informative Knowledge Encyclopedia series. Complete the collection and dive into the deep with Knowledge Encyclopedia Ocean! , take a trip to the solar system with Knowledge Encyclopedia Space! and travel back to prehistoric times with Knowledge Encyclopedia Dinosaur ! , > , Erscheinungsjahr: 20240502, Produktform: Leinen, Seitenzahl/Blattzahl: 208, Themenüberschrift: JUVENILE NONFICTION / Transportation / Aviation, Keyword: transport book for kids; transport book for children; children's transport encyclopedia; kids transport encyclopedia; car book; train book; plane book; motorbike book; bus book; kids train book; car book for kids; boat book; children's encyclopedia; kids encyclopedia; kids book 9-12; childrens book 9-12; childrens book 10-11; kids book 10-11; childrens books age 9-11; kids books age 9 12; books for 9 year olds; books for 10 year olds; books for 11 year olds; books for 12 year olds, Fachschema: Englische Bücher / Kinderliteratur, Jugendliteratur / Sachbuch~Fahrzeug / Kindersachbuch, Jugendsachbuch~Flugzeug / Kindersachbuch, Jugendsachbuch~Schiff / Kindersachbuch, Jugendsachbuch, Fachkategorie: Kinder/Jugendliche: Nachschlagewerke: Enzyklopädien, allgemeine Nachschlagewerke, Interesse Alter: empfohlenes Alter: ab 9 Jahre, Altersempfehlung / Lesealter: 18, ab Alter: 9, bis Alter: 12, Imprint-Titels: DK Children, Warengruppe: HC/Kinderbücher/Sachbücher/Naturwissensch./Technik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 307, Breite: 261, Höhe: 22, Gewicht: 1352, Produktform: Gebunden, Genre: Importe,26,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
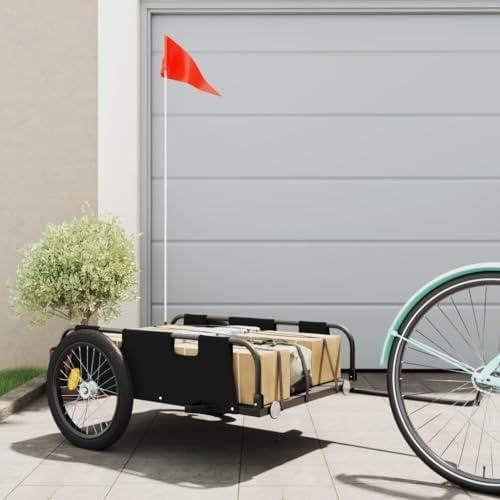
Fahrrad-Lastenanhänger für den Transport schwerer Güter mit moderner KonstruktionDieser robuste Fahrrad-Transportanhänger besteht aus pulverbeschichtetem Eisen. Der Bezug aus Oxford-Gewebe ist leicht, wasserabweisend sowie widerstandsfähig gegen Beschädigungen und Schmutz. Zwei große Räder ermöglichen eine reibungslose Fahrt und eine zuverlässige Spurführung auf verschiedenen Untergründen. Die Reflektoren an der Rückseite verbessern die Sichtbarkeit bei schlechten Sichtverhältnissen. Farbe: Schwarz. Material: Oxford-Gewebe, pulverbeschichtetes Eisen. Gesamtabmessungen: 135 x 68 x 38,5 cm (L x B x H). Abmessungen der Kabine: 80 x 55 x 20 cm (L x B x H). Länge der Flagge: 139 cm. Maximale Tragfähigkeit: 45 kg. Deichsellast: 3-11 kg. Zusammenbau erforderlich: Ja. Alle AUVYI-Produkte werden aus langlebigen, hochwertigen Materialien unter strengen Qualitätskontrollstandards hergestellt, um ein dauerhaftes Produkt für Ihr Zuhause zu schaffen. Wenn Sie nach Erhalt des Produkts Fragen haben, können Sie uns . Das professionelle Kundensupport-Team hilft Ihnen, diese innerhal442,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.